近日,SmartX 研发团队针对虚拟化网络提出的 BIG TCP 性能优化方案,经 Linux 内核社区多轮评审后,已合入 Linux 主线,预计随 Linux 7.4 正式发布。这项改进解决了不同网络设备混用时启用 BIG TCP 可能出现的性能回退问题,让更多现有设备能够发挥网络加速技术的价值。
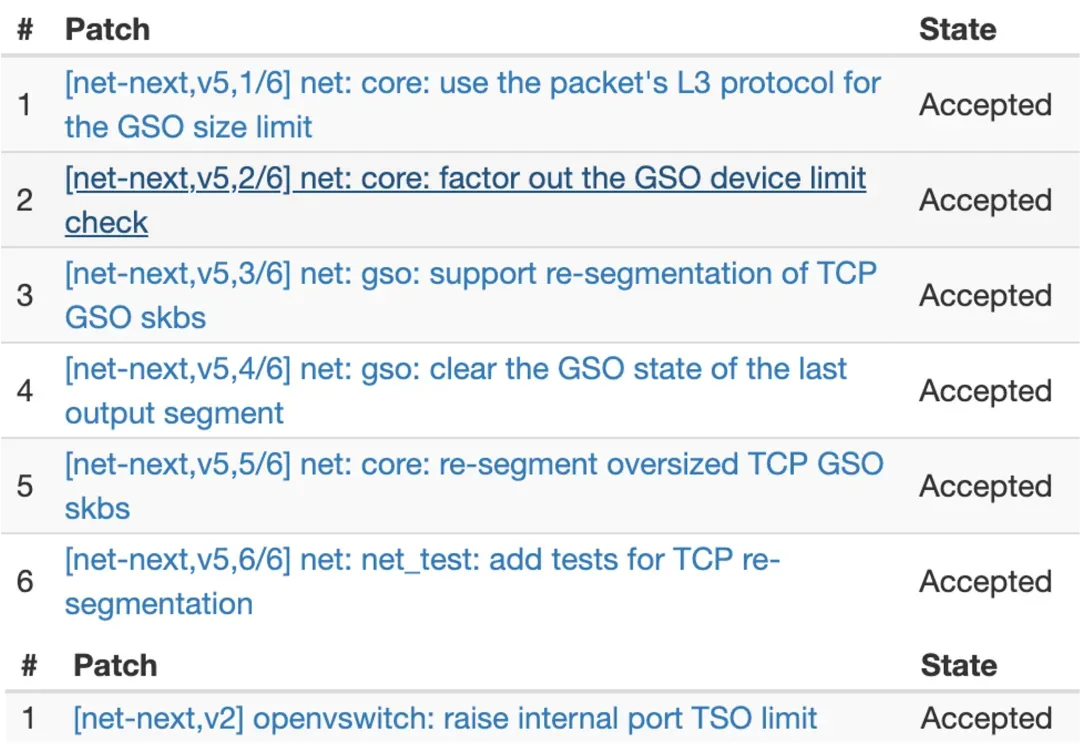
从虚拟化场景中发现性能瓶颈,到改进 Linux 底层网络处理机制,再到通过社区评审形成可复用的内核能力,这项成果体现了 SmartX 在虚拟化与操作系统底层的研发积累。在提交给 Linus Torvalds 的 Linux 7.4 网络子系统更新摘要中,维护者也专门列出了这项 BIG TCP 重分段改进。
以下,我们将从 BIG TCP 的机制与虚拟化数据路径出发,详细介绍这一性能优化实践。
BIG TCP 在虚拟化网络中的路径分析及优化方向
虚拟机发送的 TCP 数据包通过虚拟网卡,经宿主机上的虚拟交换机转发后,由物理网卡发出。这些环节的报文处理、排队和转发都需要 CPU 参与;随着吞吐提高,单位时间内需要处理的报文增多,CPU 开销也随之增加。当单流吞吐达到数十 Gbps 时,即使链路带宽还有余量,CPU 也可能先成为瓶颈。要继续提速,就需要减少软件栈处理相同数据量时的 CPU 开销。
Linux 使用 skb 描述网络报文。GSO 允许发送侧先把多个 TCP 段放在一个聚合 skb 中,延后到出口再分段;GRO 则在接收侧把多个报文聚合起来,减少上层协议栈需要处理的 skb 数量。聚合包保留了每个 TCP 段的大小(MSS)和段数等信息,下游设备可以据此继续完成分段卸载。
BIG TCP 是一种支持传输更大数据段、从而减少网络数据包数量和处理开销的 TCP 优化技术。传统 TCP GSO 支持最大约 64 KiB 的聚合包,BIG TCP 则将这一上限提高到约 512 KiB。这些大包在软件栈中传递,到出口再按物理链路能力分段,链路 MTU 保持不变。处理相同数据量时,软件栈需要创建、遍历和排队的 skb 更少。
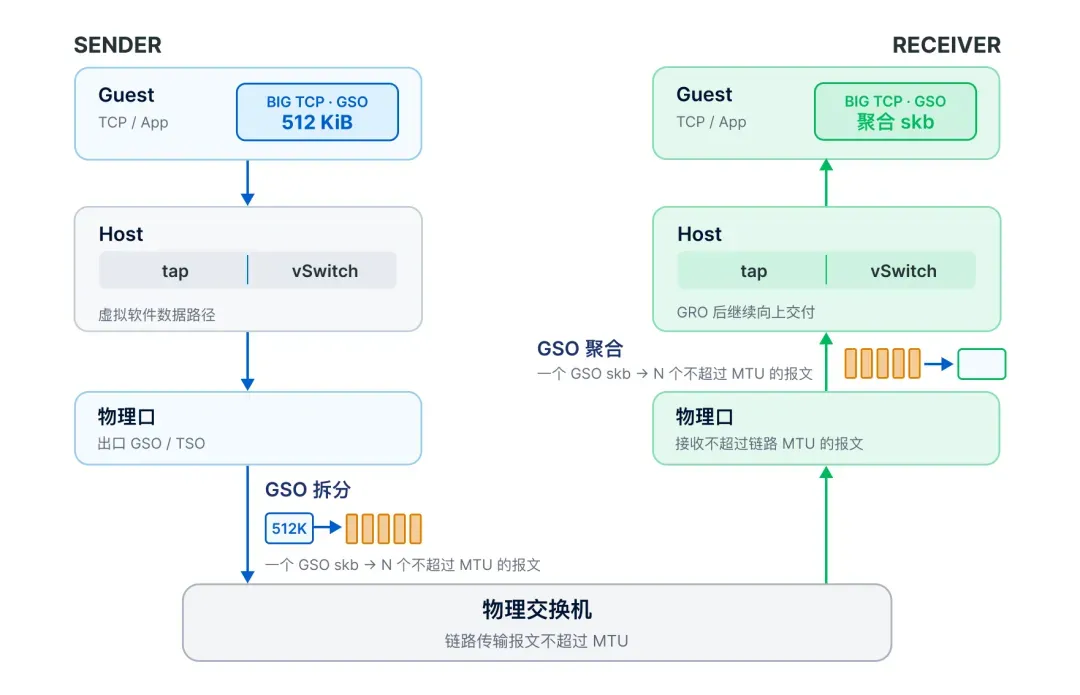
图 1:BIG TCP 在虚拟化数据路径中的 GSO 拆分与接收端 GRO 聚合。
聚合包携带的多个 TCP 段可以共用一次设备调用和队列操作。这种聚合状态保留到后续环节时,减少逐包处理的收益也会沿数据路径累积。在 SMTX OS 的虚拟化场景中,启用 BIG TCP 可以降低处理相同数据量所需的 CPU 开销,提升单流吞吐,让现有硬件承载更多网络流量。
对于软件实现的虚拟网卡和虚拟交换机,可以通过软件适配支持更大的聚合包;物理网卡能否直接对这类大包执行分段卸载,则取决于网卡硬件和驱动支持。我们围绕软件路径展开优化,让大包在虚拟机和宿主机中尽量保持聚合,并在物理出口适配现有网卡的能力。
针对大聚合包的重分段优化与性能测试
混合场景的性能回退
为了评估 BIG TCP 在虚拟化网络中的实际收益,我们对不同数据路径的性能表现进行了全面测试。测试中我们发现,当虚拟机发送约 512 KiB 的聚合包,而出口物理网卡的 GSO 上限为 64 KiB 时,开启 BIG TCP 后吞吐反而下降。
虚拟机(发送约 512 KiB 的 BIG TCP 聚合包)
→ virtio-net → vhost-net → tap → ovs datapath
→ 物理网卡(GSO 上限为 64 KiB)
检查出口处理逻辑后,我们找到了问题:当聚合包超过网卡支持的长度或分段数上限时,旧路径会直接进行完整软件分段,将大包拆成逐个 TCP 段的普通报文。
这使一个大包变成了大量需要由软件分别处理、提交给网卡的小包。物理网卡原本仍能对 64 KiB 以内的聚合包执行 TSO,但旧的分段方式没有利用这项能力。BIG TCP 在虚拟机和宿主机中积累的聚合收益,便在物理出口被大量逐包操作抵消。
重分段优化
为了兼容不支持 BIG TCP 的物理网卡,需要在出口将大包调整到网卡支持的大小,继续利用硬件分段卸载。
我们为 Linux GSO 增加了重分段能力:内核先检查出口网卡支持的聚合大小,再将超限大包拆成多个符合网卡能力的聚合包。这些较小的包继续携带分段信息,可以交给网卡完成硬件分段。
以约 512 KiB 的大包进入 64 KiB 出口为例,原来的完整软件分段会产生数百个普通包;重分段则生成少量较小的聚合包。软件需要逐个处理和提交的对象因此减少,最终按链路 MTU 拆分报文的工作继续由网卡完成。
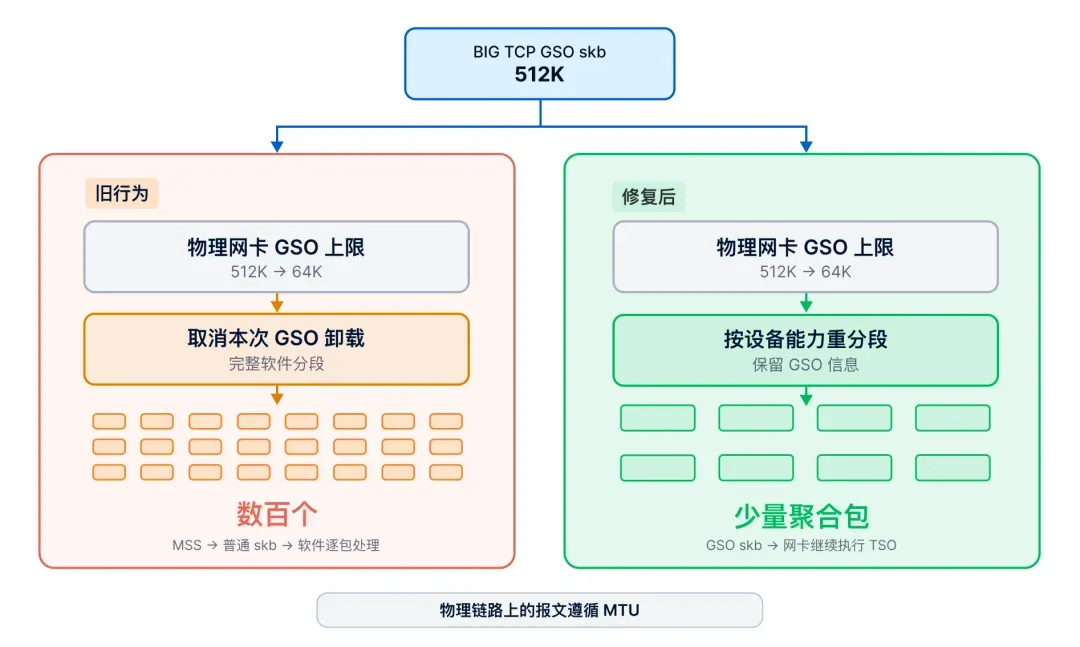
图 2:重分段将大包调整到物理网卡能够接收的大小,保留硬件分段卸载能力。
这样,虚拟机和宿主机可以继续使用更大的聚合包,出口网卡也能沿用原有的分段卸载能力,平台可以在客户现有硬件上逐步启用 BIG TCP。
端到端测试结果
我们在完整的 VM-to-VM 路径中,对比了 BIG TCP 开启、关闭以及混合场景下修复前后的性能表现。运行内核为 6.6.119-48.3.v85.tl3.x86_64,通过 livepatch 部署与最终上游补丁等价的数据路径。两台 VM 依次经过:
virtio-net → vhost-net → tap → ovs datapath → tap → vhost-net → virtio-net
本次测试将 BIG TCP 上限设置为 389120 字节,legacy GSO 上限设置为 65536 字节。每个样本使用一条 TCP 流,固定到 guest CPU1,运行 10 秒。四类场景按轮次交错执行;CV 超过 5% 或极差超过均值 10% 的场景补测 10 组,最终共完成 60 组。具体性能表现如下。
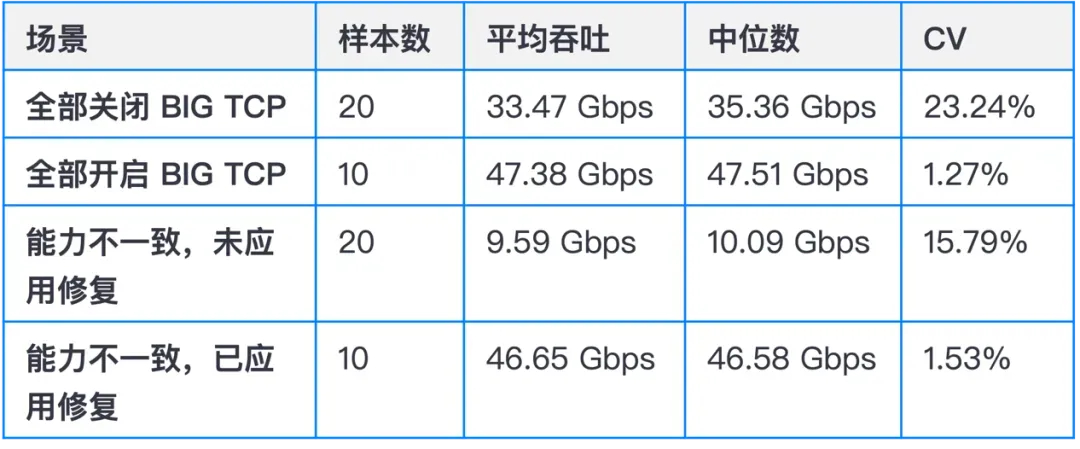
完整开启 BIG TCP 后,平均吞吐从 33.47 Gbps 提高到 47.38 Gbps,提升约 41.6%;中位吞吐从 35.36 Gbps 提高到 47.51 Gbps,提升约 34%。同时,吞吐的变异系数(CV)从 23.24% 降至 1.27%,波动大幅减小。
混合路径的改善更加明显。未应用修复时平均只有 9.59 Gbps;重分段后达到 46.65 Gbps,是原路径的 4.86 倍,并达到完整 BIG TCP 吞吐的 98.5%。混合场景的 CV 从 15.79% 降至 1.53%,修复后的吞吐也更加稳定。
运行时观测到的最大中间 GSO skb 为 65226 字节,低于 65536 字节的出口上限。全部 60 组测试均未出现 TCP 重传。完整开启 BIG TCP 直接减少协议栈中的 skb 数量,重分段则让能力不一致的路径继续保留这种聚合收益。
合入 Linux 主线
后续,我们将补丁提交到 Linux netdev 社区,并经过多轮评审和迭代。Willem de Bruijn 关注了重分段判断在发送热路径上的位置。在这条频繁执行的路径中,新增的报文头读取和设备能力检查,也会随报文数量累积成开销。根据评审意见,我们将这些操作放到本来就需要分段的分支中,设备能够直接接收的报文继续沿原有路径发送。
Paolo Abeni 提出了另一种实现思路:由调用方直接调整报文参数,再交给现有分段逻辑。我们比较了两种方案需要的数据拷贝、重复逻辑和 IPv4 边界处理,最终保留了对 GSO 引擎的有限扩展,复用已有的数据组织和报文头处理过程。
评审还讨论了分组上限应由哪一层决定。skb_segment() 同时服务于 qdisc、ovs upcall 和 tap 等路径,其中部分调用方需要主动获得逐个 MSS 的普通包。最终由调用方显式传入分组上限,使重分段能够使用同一个 GSO 引擎,也让其他调用方保持各自需要的分段行为。
随着评审推进,我们补充了不同包长和分段组合的自动化测试,逐项检查输出结果,并修正了 VLAN 场景中的协议识别等细节。目前,这组补丁从 v1 迭代到 v5,逐步完成了热路径调整、调用接口整理和测试补充,最终合入 Linux 7.4。
* 感谢 Willem de Bruijn、Paolo Abeni 及 netdev 社区在方案讨论、代码评审和补丁合入过程中的帮助。
其他 BIG TCP 优化
重分段解决了 BIG TCP 大包经过能力较低设备时的关键回退问题。围绕 BIG TCP,我们还从更多设备支持和数据拷贝效率两个方向推进了配套优化。
ovs internal port 支持
当宿主机自身需要通过 ovs 与虚拟机或外部网络通信时,会用到 internal port。可以将其理解为宿主机接入虚拟交换机的一块虚拟网卡,宿主机通过它向 ovs 发送报文,也接收 ovs 转来的报文。
此前,ovs datapath 已能转发 BIG TCP 大包,但 internal port 的聚合上限仍为约 64 KiB。因此,即使其他设备已经支持 BIG TCP,宿主机通过这个端口发送报文时,仍无法使用更大的聚合包。
我们为 internal port 增加了 BIG TCP 支持,将其可配置的聚合上限提高到约 512 KiB。启用后,宿主机可以用更少的聚合包发送相同的数据,减少软件栈的逐包处理开销。相关修改已合入上游。
在同一台宿主机上,我们对经过 internal port 的 TCP 流量进行对比测试,保持其他设备和配置不变,仅调整该端口的聚合上限。IPv4 单流吞吐从 65.57 Gbps 提升到 77.42 Gbps,提升约 18.1%;IPv6 从 55.36 Gbps 提升到 74.57 Gbps,提升约 34.7%。
Hygon AVX2 copy 优化
AVX2 可以利用向量指令批量搬运数据,加速大块内存拷贝。我们将这项优化移植到 Hygon 平台的 vhost-net 收包路径,用于将网络报文从宿主机拷贝到虚拟机内存,在提高拷贝效率的同时,减少大块数据对 CPU cache 的占用。
AVX2 拷贝也有准备和收尾的固定开销。每次拷贝的内存块越大,这部分开销就越容易被摊薄,加速收益也越明显。BIG TCP 提高了报文聚合上限,让 vhost-net 一次收包操作能够处理更多数据。我们还将同一次收包操作中的多个拷贝片段作为一批处理,减少重复的准备和收尾工作,让更大的聚合包充分发挥 AVX2 的拷贝效率。
在 Hygon C86 平台上,我们使用经过 ovs datapath 的 VM-to-VM 单流测试,对比已有 AVX2 copy 与叠加 BIG TCP、批量拷贝优化后的表现。测试使用同 NUMA、单队列配置,关闭 zerocopy,每轮运行 20 秒。基线的 GSO 上限为传统 64 KiB;组合方案将两端 GSO/GRO 上限设置为 389120 字节。
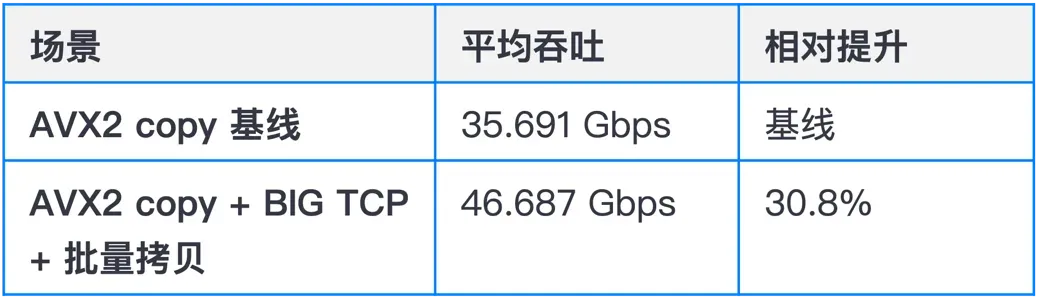
在已有 AVX2 copy 的基础上,组合方案又增加了约 11 Gbps 的单流吞吐,20 轮测试均未观察到 TCP 重传。目前,该功能仍在内部审查和测试中,预计将在后续版本中发布。
下一步计划
虚拟机侧的 BIG TCP 支持是 我们接下来向社区推进的重点。我们将继续推进 virtio-net 的 BIG TCP 支持和能力协商,让 guest 与不同后端能够协商更大的报文上限,并完成设备侧的联调验证。
能力协商可以让更多虚拟设备直接传递大包,重分段则负责在物理网卡或其他设备的能力边界处调整聚合大小。两者配合,既能扩大 BIG TCP 在软件路径中的覆盖范围,也能兼容客户现有的网络硬件。
参考资料:
1. Linux netdev BIG TCP 重分段补丁系列:https://patchwork.kernel.org/series/1181528/
2. ovs internal port series:https://patchwork.kernel.org/series/1166144/
3. LWN,Going big with TCP packets:https://lwn.net/Articles/884104/
4. BIG Performances with BIG TCP on Cilium:https://isovalent.com/blog/post/big-tcp-on-cilium/
推荐阅读: