近日,SmartX 正式发布榫卯 AI 平台 1.2 版本,围绕模型支持、异构算力纳管和模型部署与管理等企业级场景,进一步扩展平台能力。
- 模型支持:引入自研推理引擎 Flex Engine,支持 MinerU、PaddleOCR 等非大语言模型,帮助用户在一套 AI 底座上完成多种模型的统一部署、发布和调用。
- 算力支持:扩展对昇腾 NPU 的适配范围,支持昇腾 NPU 切分和完整的可观测性能力,帮助用户提升异构算力资源利用率。
- 运维管理:通过模型仓库可视化管理、自动计算 KV-Cache 与显存需求以及 APIKey 分组管理,让模型管理与资源规划更简单。
更丰富的模型种类支持
从 LLM 扩展到 OCR 与机器学习模型,支持更多 AI 应用场景
企业建设 AI 平台时,往往需要同时管理不同类型的模型:除大语言模型外,也需要文档解析、OCR、传统机器学习等模型,支持图像处理、文档识别等应用场景。由于这些模型涉及很多“非推理”工作(如 PDF 识别、格式处理等),企业往往需要额外部署虚拟机/容器,与 vLLM 等推理引擎配合支持模型运行。这不仅增加了团队准备运行资源的工作负担,也难以实现不同环境间的统一 API 管理与模型治理。
榫卯 AI 平台 1.2 在既有标准推理引擎(vLLM、SGLang 等)能力基础上,引入自研推理引擎 Flex Engine,支持 MinerU、PaddleOCR 等模型和部分机器学习模型。这意味着,用户可以在同一平台中统一纳管语言、多模态、Embedding、Rerank、文档解析、OCR 和机器学习模型等多类模型资产,并使用榫卯 AI 平台的统一模型网关能力完成服务发布和调用管理。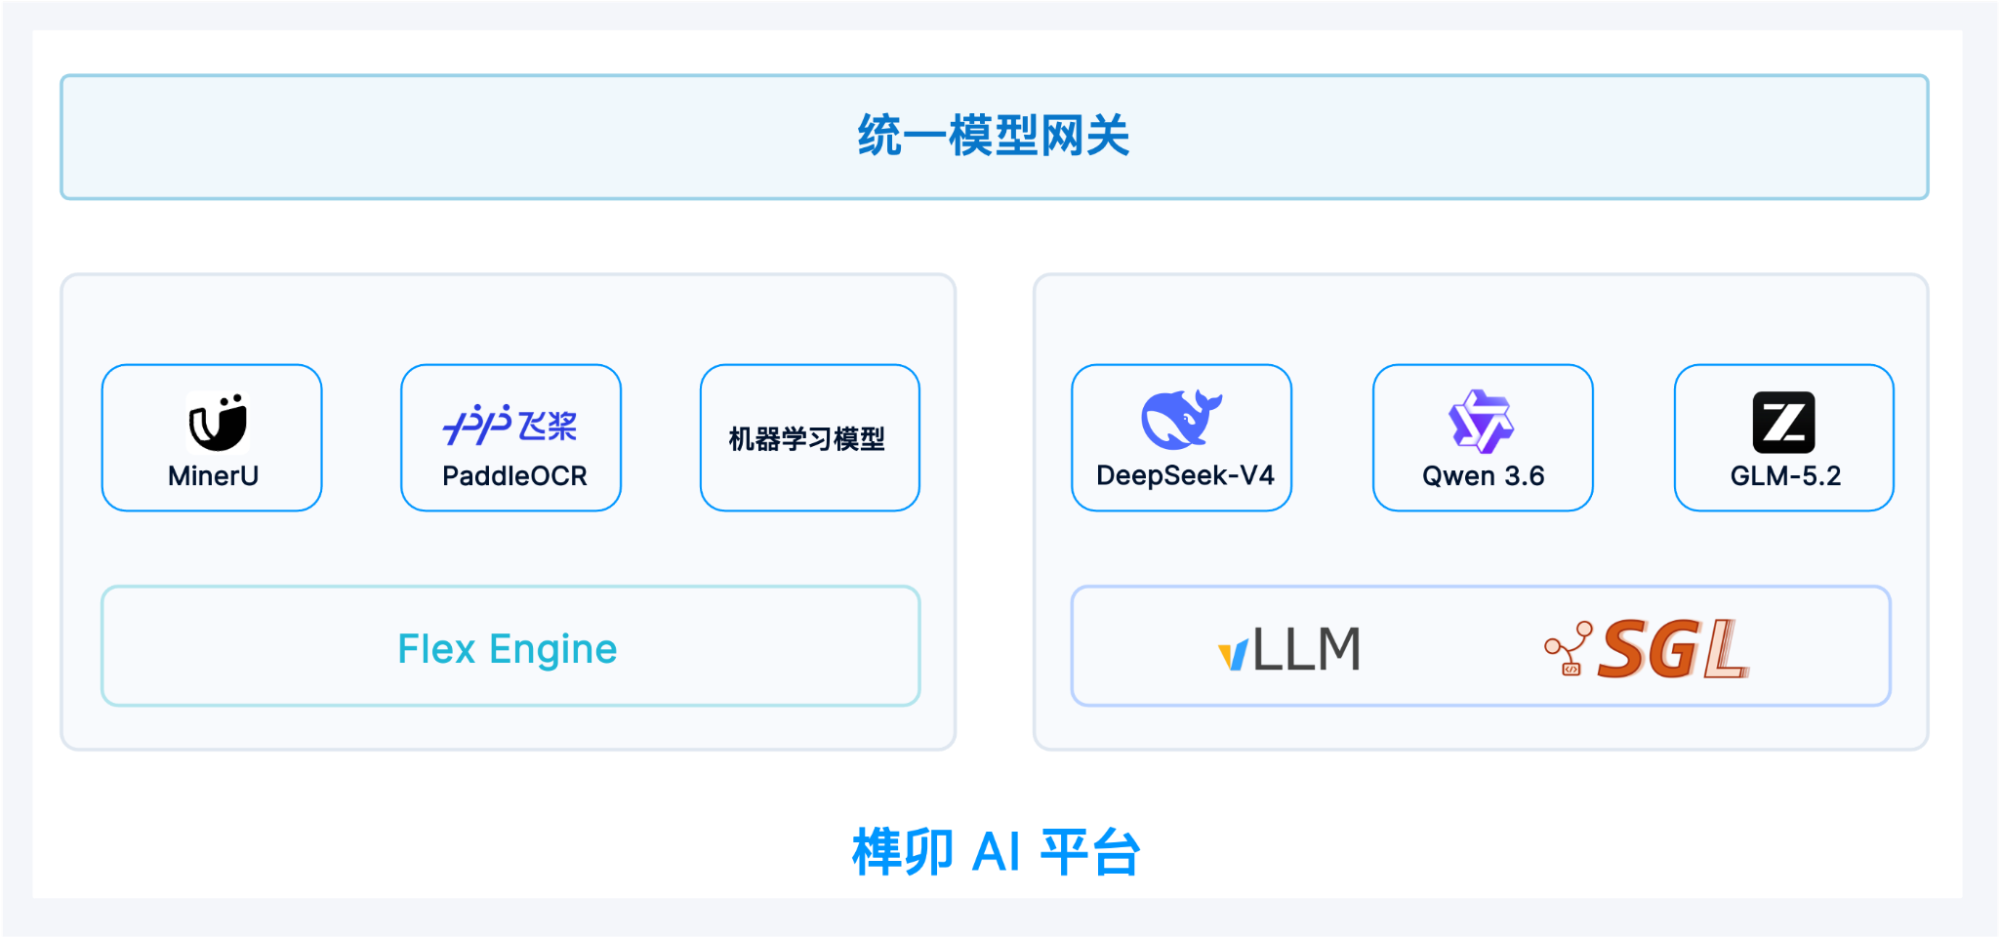 对于平台建设团队而言,这有助于减少重复建设,提升部署管理效率;对于业务团队而言,也能以更一致的方式获取不同类型的 AI 能力,加快模型从验证到业务接入的过程。
更多元的 AI 芯片支持
扩展昇腾 NPU 支持范围,提供 NPU 虚拟化与完整可观测性能力
针对企业用户的多种算力使用需求,榫卯 AI 平台 1.2 进一步扩展昇腾 NPU 支持范围,在既有的 Atlas 300I Duo/Pro 支持基础上,新增对 910B、910C 等型号的支持。同时,支持企业用户对昇腾 NPU 进行切分(vNPU),将整卡资源划分为更细粒度的算力单元,支持多个模型按需使用资源,减少资源闲置。
新版本也围绕 NPU 资源提供完整可观测性能力,帮助平台管理员在统一视图中查看算力资源状态、使用情况和运行异常。结合平台统一调度能力,用户可以对整个 AI 算力池(含 NVIDIA、昇腾、CPU 等)进行统一的资源管理与使用监控,提升异构资源利用率与资源管理效率。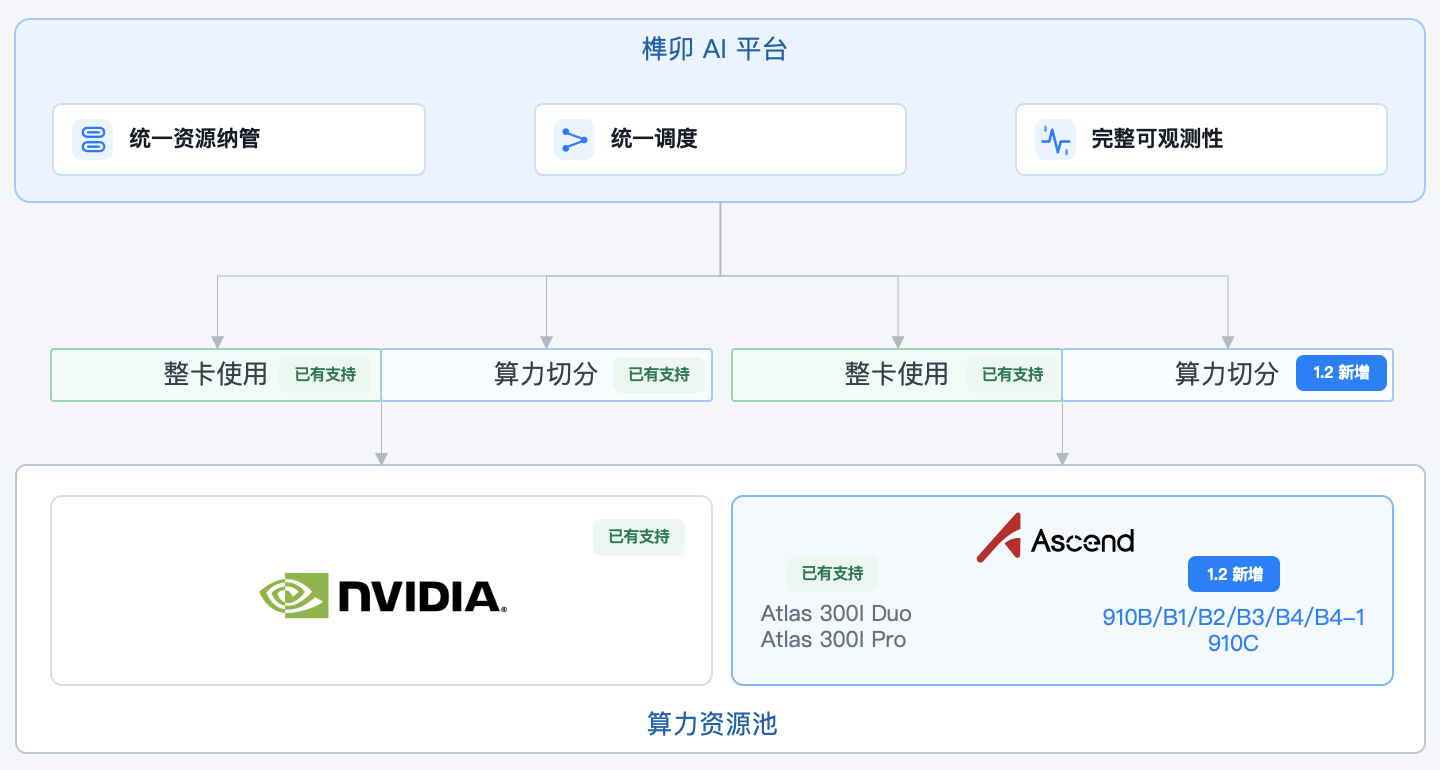
更简单的资源规划与管理
支持模型仓库可视化管理,让模型资产清晰可见
部署模型前,企业用户通常需要先从 ModelScope、Hugging Face 等公有模型仓库下载模型,并在模型详情页查阅来源、参数、规模、精度等关键信息,以辅助部署决策。随着模型数量持续增加,逐一检索和确认模型信息的成本不断上升。因此,平台团队需要在模型部署与管理过程中,能够快速获取各模型的来源、参数规模及其他关键属性,从而提升模型选型、部署和运维管理的效率,支持更加合理的部署决策。
榫卯 AI 平台 1.2 优化模型仓库可视化管理能力,支持统一管理公有与私有模型并在统一界面展示模型来源、连接状态、可见性、模型数量、存储占用和更新时间等信息。用户也可在单一模型的详情页中查看模型的具体参数量、大小、精度、上下文长度等信息,降低部署前的信息确认成本。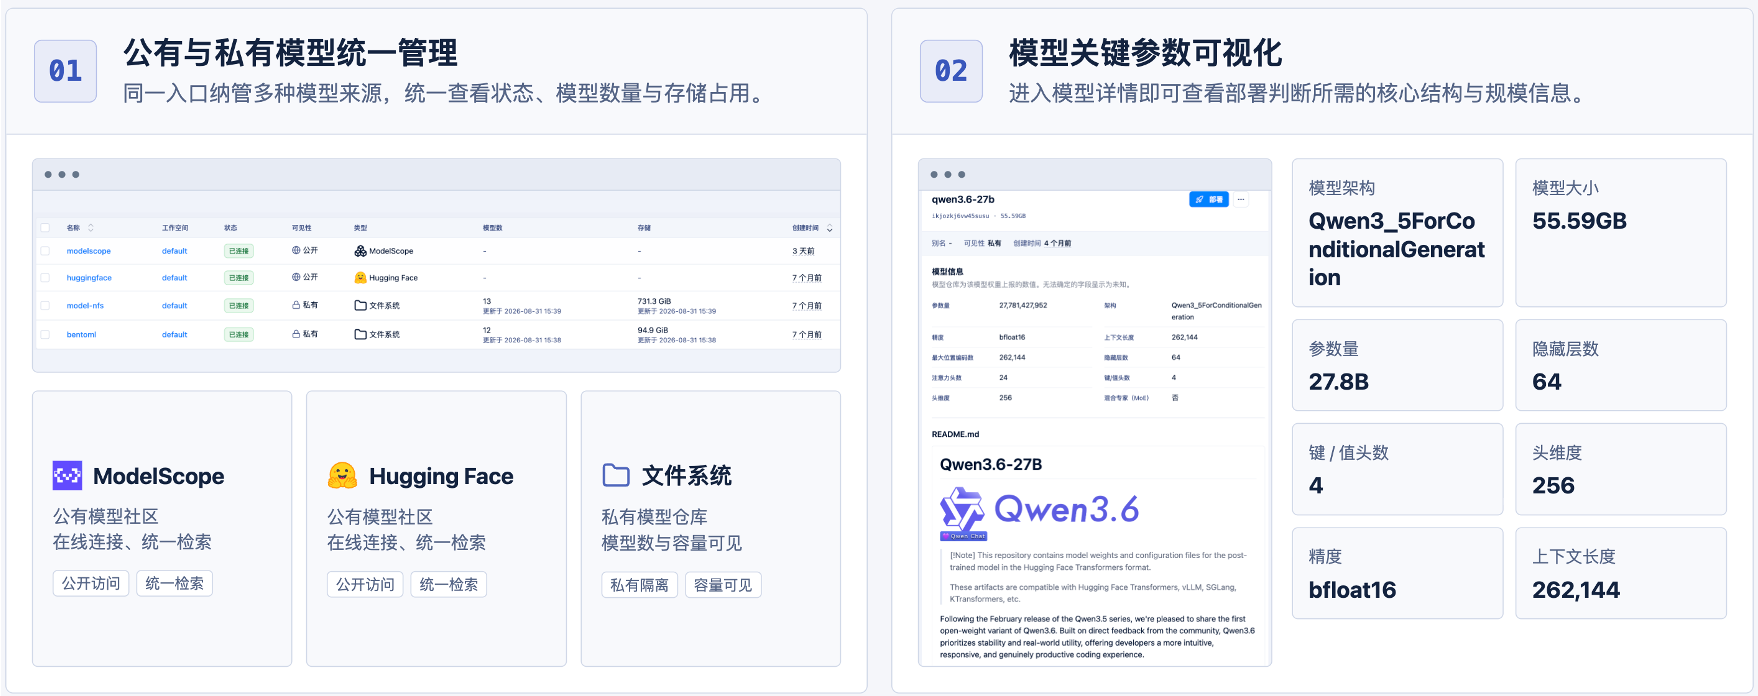
自动计算 KV-Cache 与显存需求,让模型部署可预估
大模型部署前,资源规划往往是影响上线效率和稳定性的关键环节。模型权重之外,KV-Cache 会随着上下文窗口、并发数、模型结构和精度配置变化而变化。如果依赖人工估算,容易出现资源预留不足导致部署失败,或预留过多造成显存浪费的情况。
结合模型仓库可视化管理能力,榫卯 AI 平台 1.2 支持在模型部署时自动解析模型结构、识别关键参数,并根据用户设定的上下文窗口和并发数动态计算本次部署所需的 KV-Cache。同时,平台会将模型权重与 KV-Cache 统一计入显存需求,给出部署所需的推荐显存,帮助用户结合现有资源情况评估部署方案。
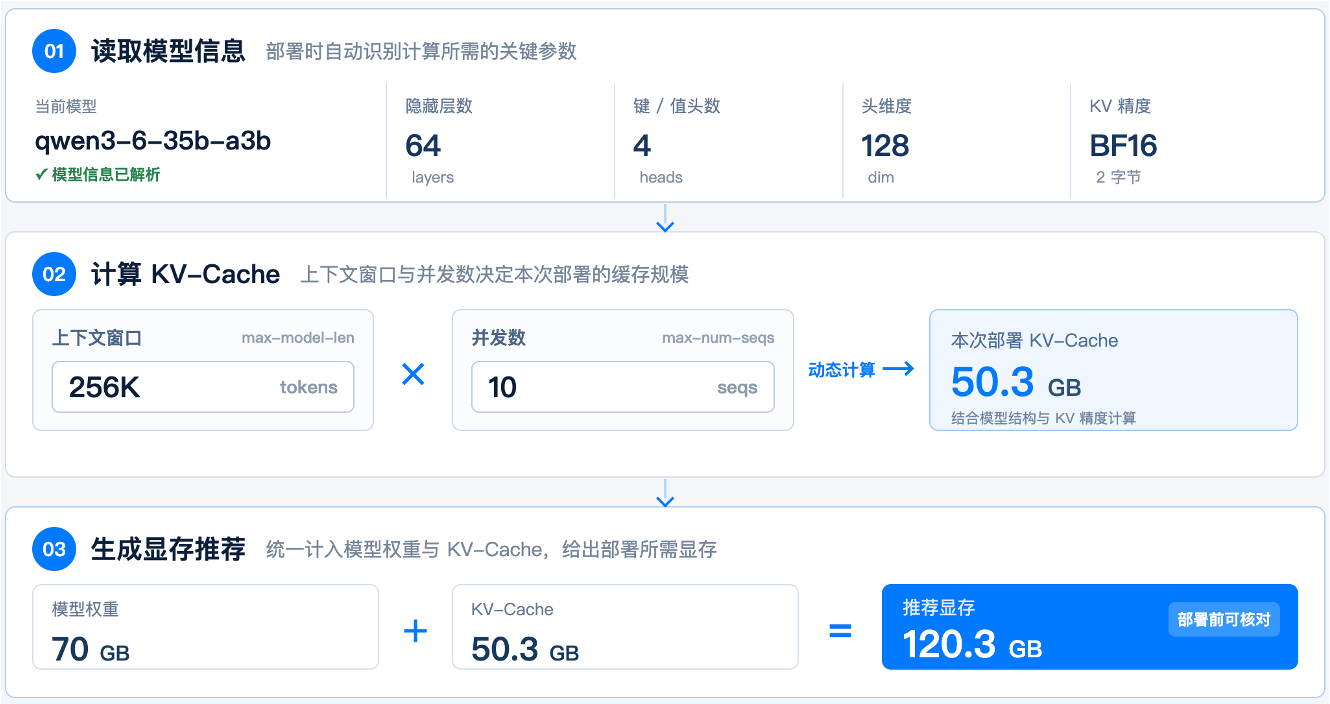
通过这一能力,用户可以在部署前完成更准确的资源核对,降低因资源不足导致的部署失败风险;同时,也能减少因资源预留过度带来的显存浪费。
支持 APIKey 分组管理,让用户看清业务归属
随着 AI 平台被多个业务团队使用,APIKey 的数量会快速增加。如果 Key 仅以线性列表呈现,且名称依赖人工命名或备注,平台管理员往往很难判断每个 Key 的业务归属和用途,后续审计、限流和问题定位也会变得复杂。
榫卯 AI 平台 1.2 引入按 Project 分组的 APIKey 管理方式。用户可以围绕业务项目聚合多个 APIKey,在创建 APIKey 时选择或直接新建 Project,并通过 Project 名称和描述共同识别业务归属。平台支持统一查看每个 Key 的工作空间、状态、用量、速率限制、支持的模型和创建时间,并提供搜索、筛选和展开查看能力。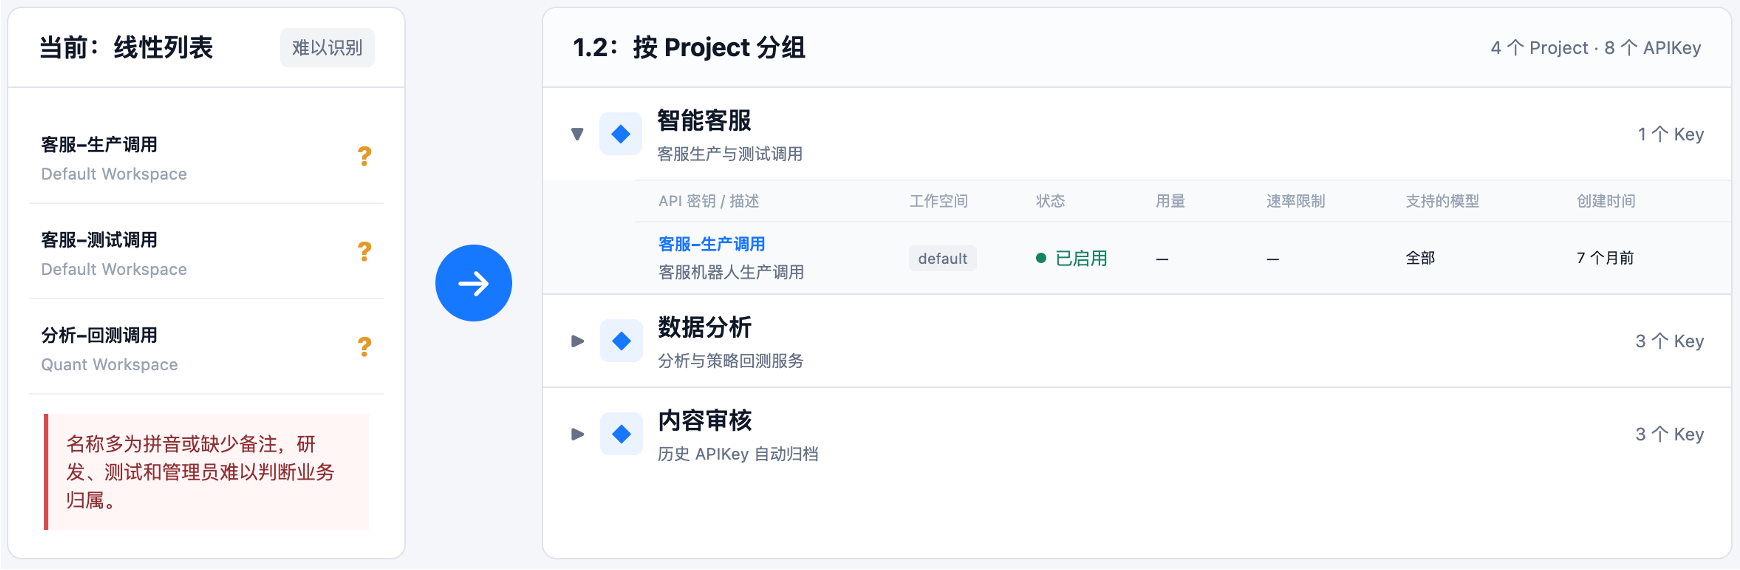
这一变化使 APIKey 管理从单纯的密钥列表,升级为以业务为导向的呈现方式。平台管理员可以更高效地识别不同业务团队的调用关系和资源使用情况,为后续调用治理、权限审计和资源计量提供更好的管理基础。
从模型接入到资源治理,持续降低企业 AI 平台建设复杂度
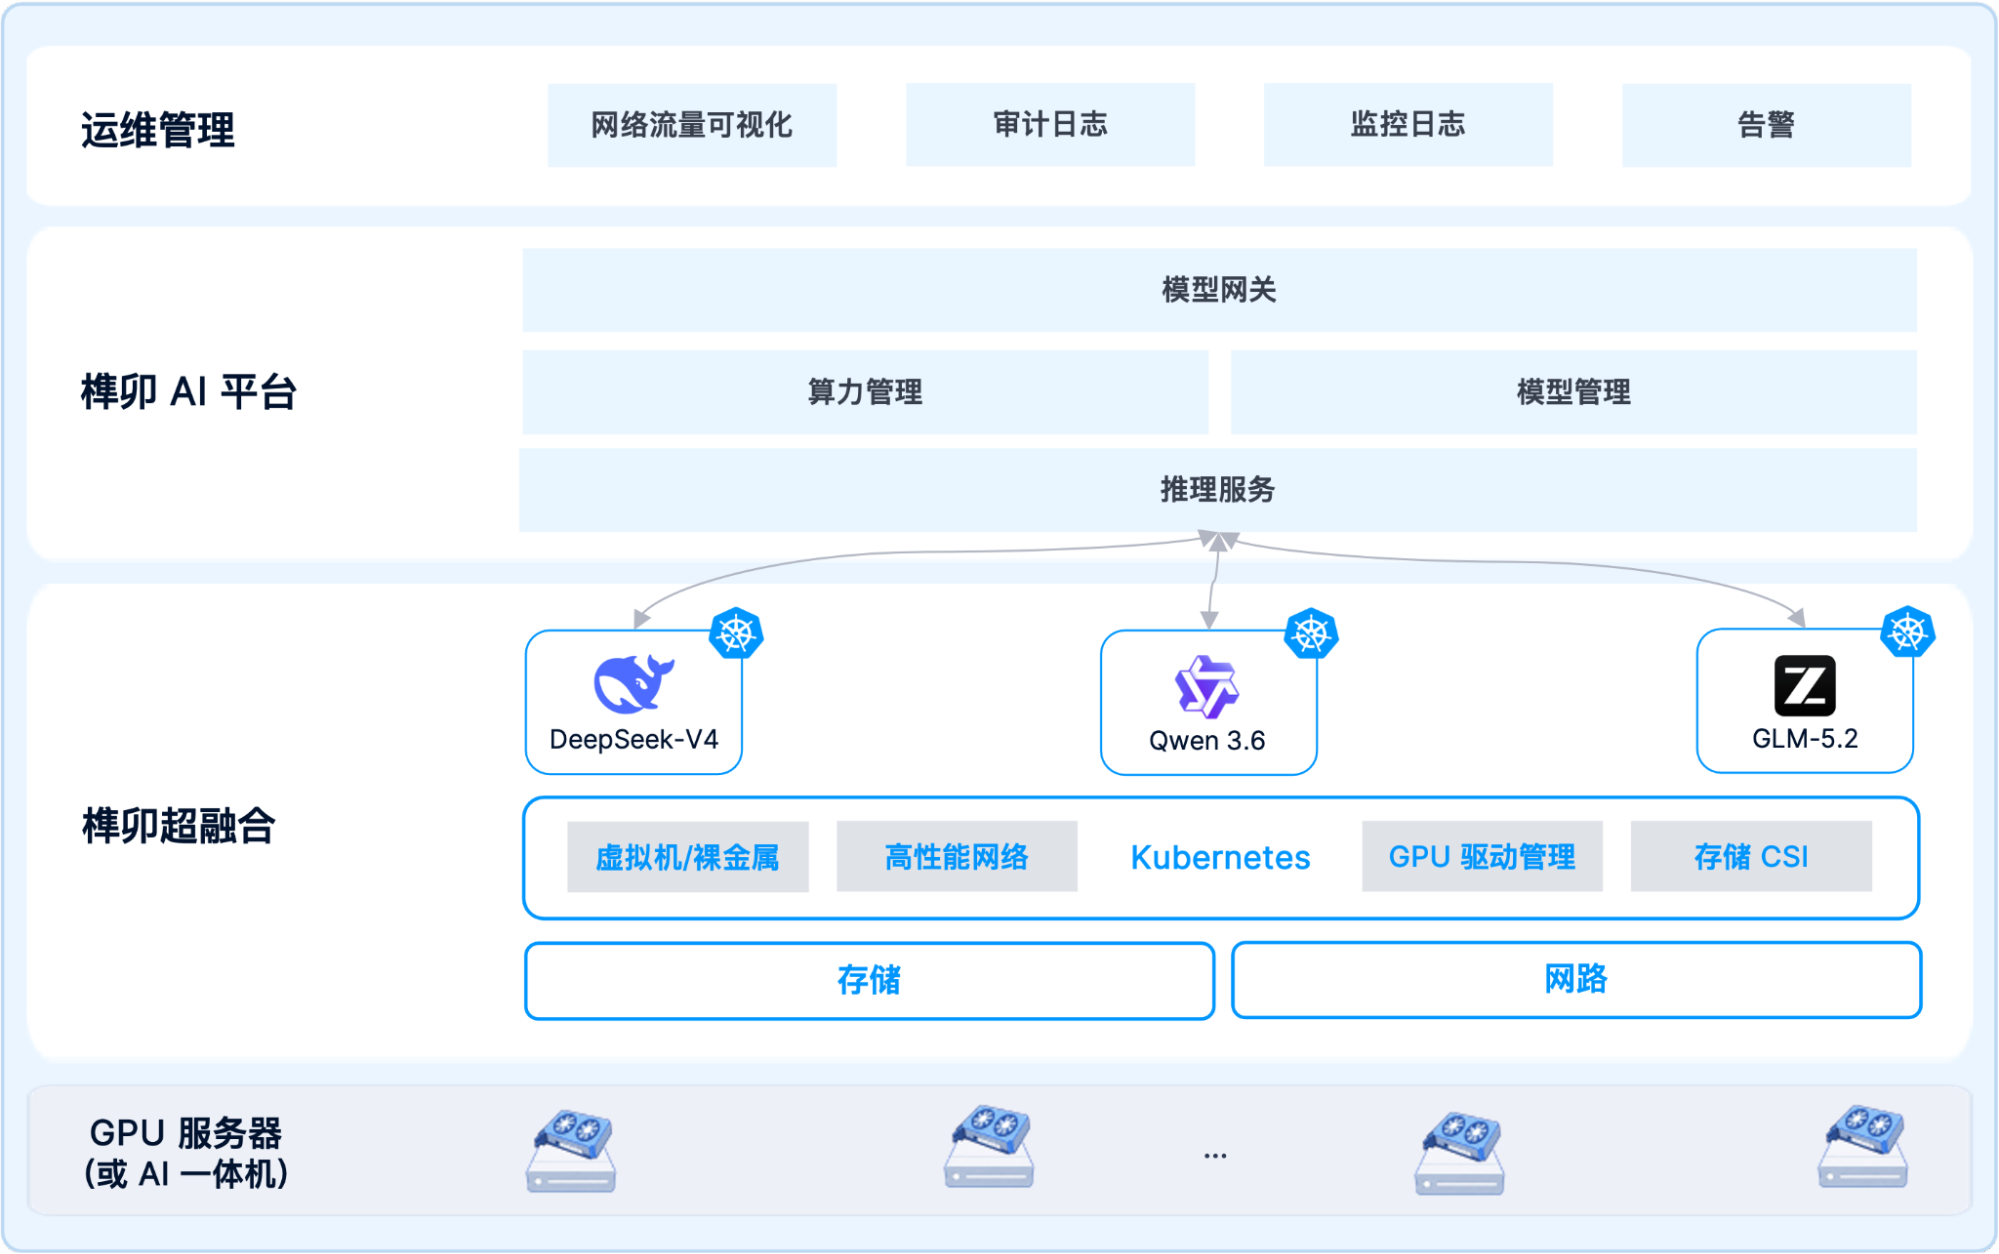
通过标准化模型交付、算力与模型统一管理、模型治理与网关管理,以及全链路可观测验证,榫卯 AI 平台帮助企业从“能部署模型”向“模型、算力和应用统一治理”演进。结合榫卯企业云平台提供的容器、存储、网络、安全和可观测能力协同,企业可构建生产级、高性能、可治理的模型推理基础设施。
目前,不少制造、医疗等行业用户已使用榫卯 AI 平台实现模型统一交付与管理:
某船舶制造用户
用户已经基于 SmartX 企业云基础设施实现虚拟化与容器业务的统一承载,并在此基础上进一步引入 AI 能力。早期,用户曾通过开源方式完成模型服务的初步尝试,但难以满足生产环境对稳定运行、快速上线、统一调用、运维支持和可观测管理的要求。
围绕统一模型服务平台建设,用户引入榫卯 AI 平台,将算力管理、模型管理和模型网关纳入同一平台,实现模型快速上线、统一调用与可视化观测,提升模型服务交付效率和运维可控性。目前,榫卯 AI 平台已支撑内部船舶规范查询、翻译、知识库等 AI 场景,并为智能体应用引入提供基础。>>了解更多
某医疗用户
用户计划面向知识库问答、文档处理、报告生成、数据分析、语音转写等场景,希望建设本地化、可管理、可审计的 MaaS 平台,为院内 AI 应用提供统一、安全、可靠的模型服务能力。
用户基于 SmartX 榫卯超融合、SKS 容器管理、文件存储以及 AI 平台,将计算、存储、容器运行环境与模型服务能力纳入统一基础设施体系。
其中,模型负载运行在 SKS 之上,并通过 CSI 为模型文件提供生产级存储与共享能力,保障模型服务的稳定运行与高效调用。榫卯 AI 平台统一纳管 LLM、OCR、ASR 等不同类型模型,并通过原生 GPU 虚拟化能力支持多模型按需共享 GPU 资源,提升有限算力资源的利用率。同时,平台结合模型网关能力,对模型调用、权限、配额、日志与安全审计进行精细化治理,帮助客户建立可控、可追溯的模型服务体系。
点击链接获取《如何构建 Agent Ready 的企业 AI 基础设施》白皮书。
推荐阅读:
榫卯AI平台1.1:增强GPU虚拟化与模型治理能力,让资源使用和模型管理更高效
榫卯AI平台扩展模型网关功能并支持DeepSeek V4和Qwen3.6等新模型
SmartX 榫卯 AI 平台企业版正式发布:助力企业构建简单、灵活、开放的 AI 基础设施
